- AmberNova20713小时前
做数据库迁移这几个月踩的坑:DataZen 0.3.0 的 Schema Diff / Data Sync / Data Transfer
之前在 G站 发过 DataZen ,当时还是 0.0.8 。这几个月一直在继续开发,现在到 0.3.0 了。
这次想聊聊里面的三个迁移功能:Schema Diff 、Data Sync 、Data Transfer 。它们分别做数据库结构比对、数据同步和异构数据库之间的数据传输。
做之前觉得这些功能应该不算太复杂,真正动手之后才发现,数据库迁移这件事比想象中麻烦得多。有些问题不实际处理一遍,很难意识到它们的复杂程度。
先说明一下测试情况:目前真正做过比较完整端到端验证的主要是 PostgreSQL 和 MySQL ,其他数据库组合还没有达到同样的验证程度。
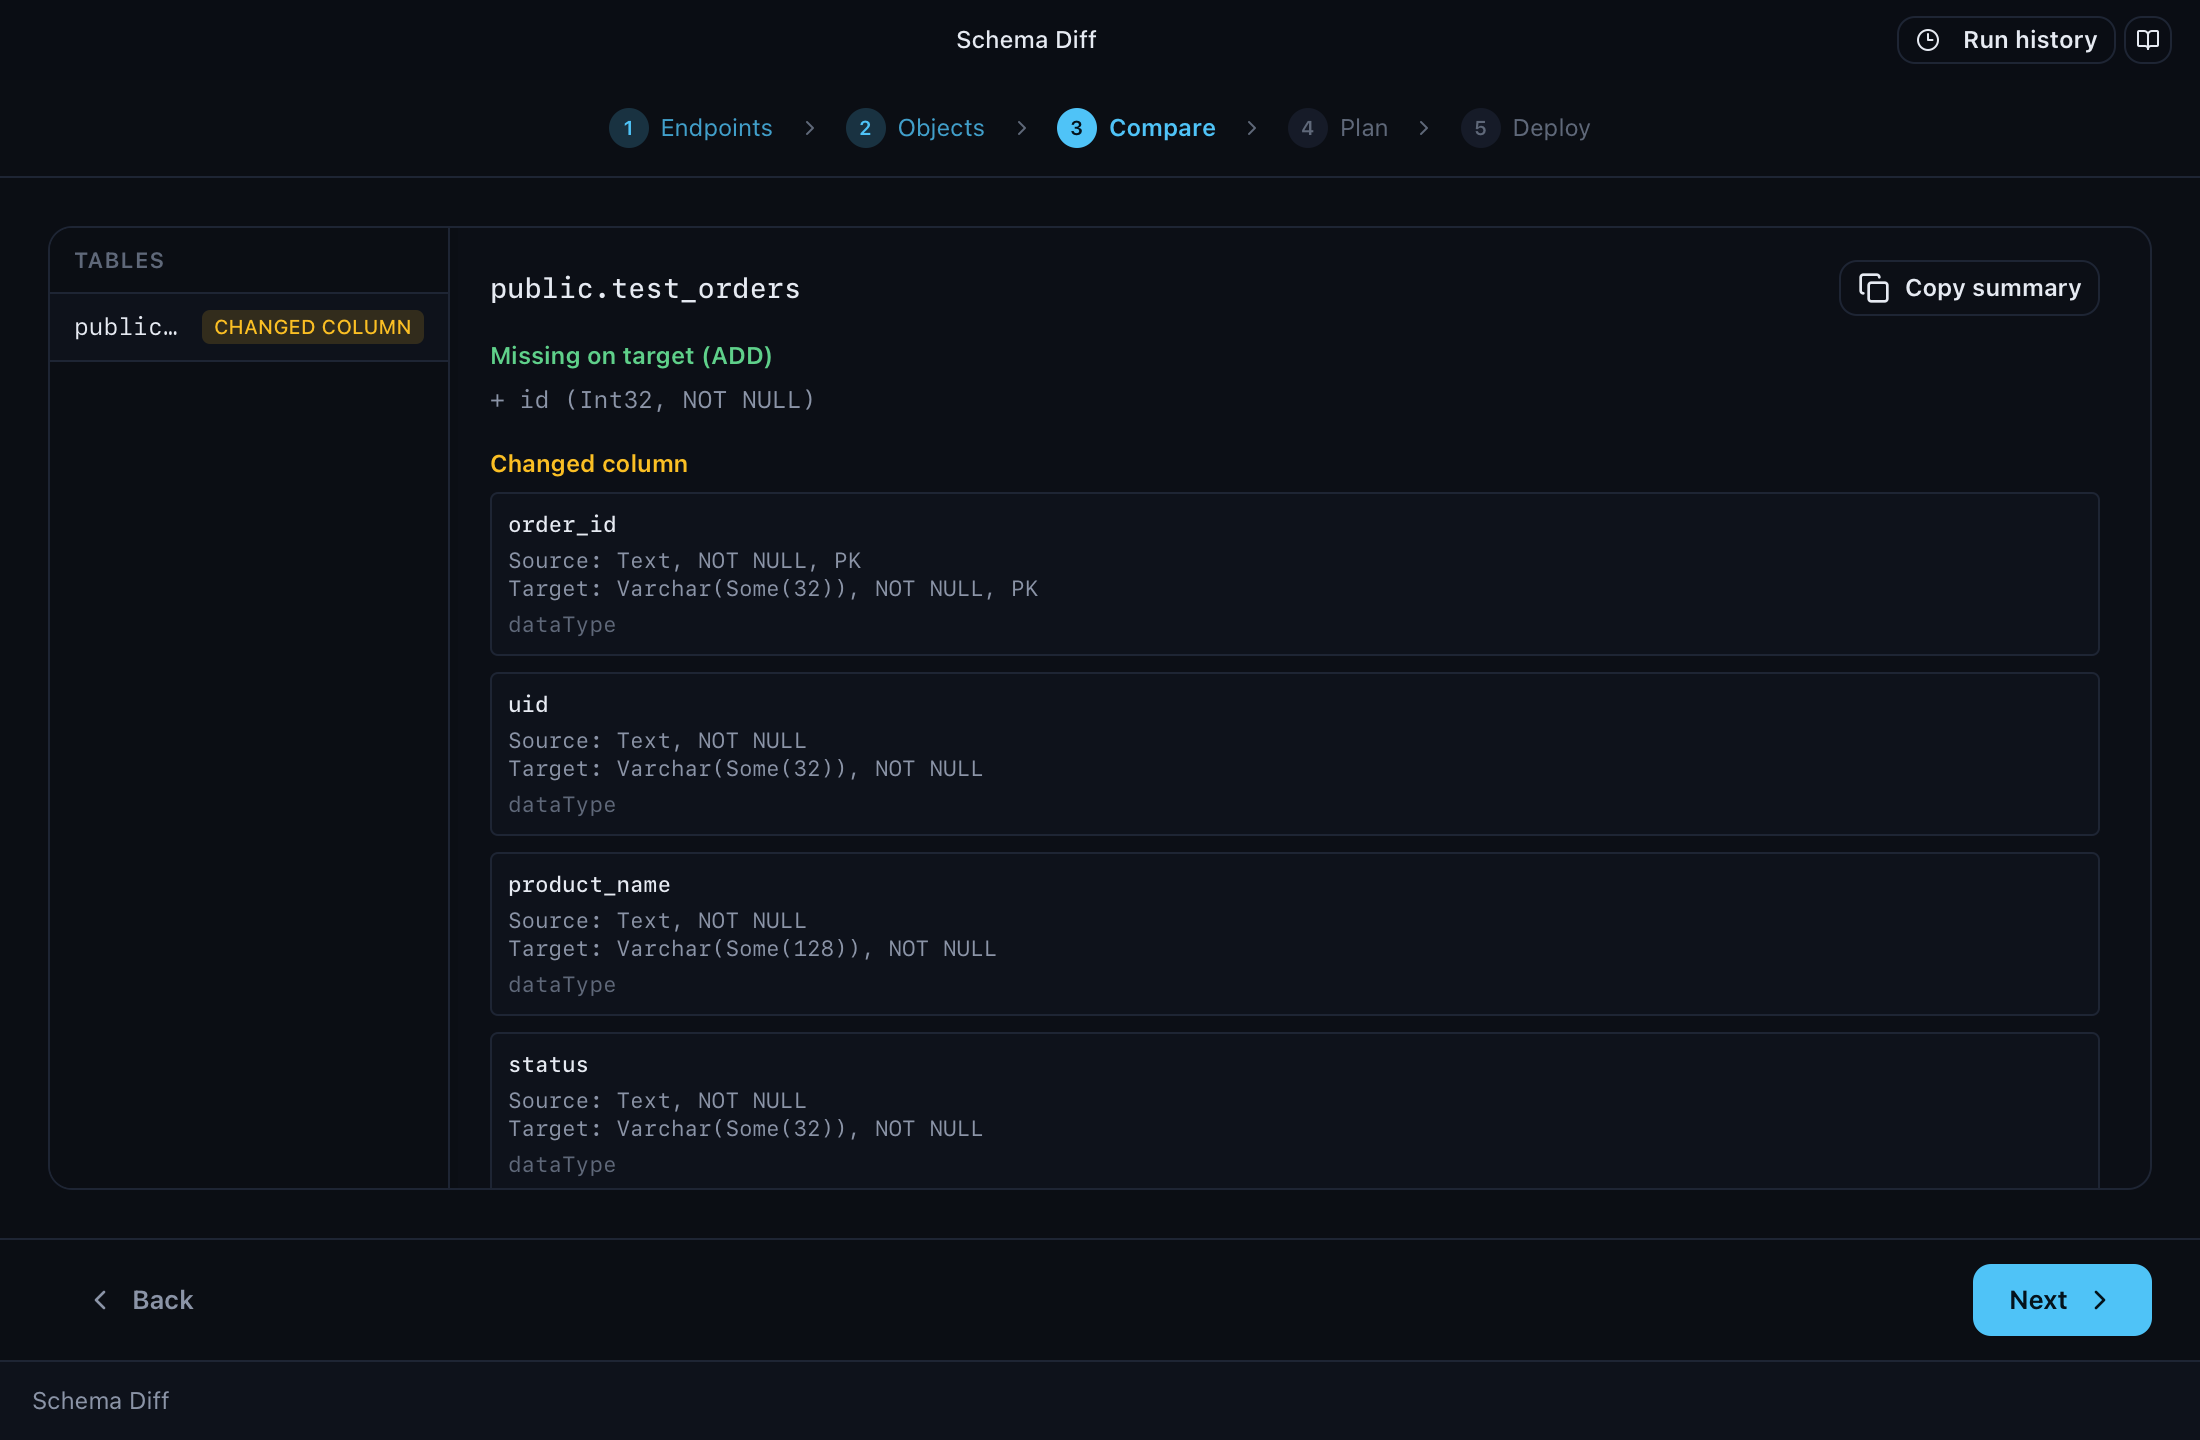
Schema Diff:生成 DDL 容易,正确执行难
一开始做 Schema Diff ,想法很直接:选择源数据库和目标数据库,比较结构差异,然后生成 DDL 。
但很快就发现,数据库对象之间有不少依赖关系。
比如,表可能依赖自定义类型和序列,外键依赖主键以及被引用的表,视图、函数、触发器之间也可能互相依赖。不同数据库对类型、索引、约束的定义方式又不一样。
如果只是把对象分组,然后按固定顺序生成 SQL ,遇到稍微复杂一点的结构就容易出问题。
所以 DataZen 后来改成了结构化的对象比较,并根据对象之间的依赖关系构建 DAG ,做拓扑排序,决定 DDL 的执行顺序。
另一个问题是不同数据库的 DDL 方言。最初如果把这些逻辑都放在核心模块里,随着支持的数据库越来越多,各种数据库类型判断会越来越难维护。现在是通过 Driver API 的 SchemaMigrationRenderer,由驱动负责渲染各自的 DDL ,同时声明支持哪些迁移操作。
举个例子,修改一张表的主键,可能同时涉及外键、索引以及其他依赖对象。到底先删除什么、再创建什么、最后恢复什么,都需要仔细处理。顺序错了,轻则部署失败,重则影响原有结构。
现在部署之前会先生成 DDL 计划,用户可以检查具体要执行的 SQL ,部署任务也支持取消。
这部分确实折腾了不少时间。越做越觉得,Schema Diff 真正难的不是比较两个数据库有哪些不同,而是怎么把这些不同转换成一套合理、可执行的变更。
Data Sync:比较数据容易,保证执行结果符合预期难
Data Sync 最开始也没想得太复杂,无非是比较两个数据库的数据,然后找出新增、修改和删除的记录。
但实际开发中,大数据量和数据变化会带来不少问题。
首先是内存。不能为了比较两个数据库,就把两边的所有数据全部加载到内存里。
其次是数据一致性。比较期间如果源库或目标库的数据发生变化,用户看到的比较结果可能已经过时。还有复合主键、跨页选择、写入冲突、任务取消和失败恢复等问题。
DataZen 在这部分做过一轮比较大的重构。
比较结果现在会生成一份不可变的执行计划,避免用户确认之后,实际执行时又重新计算出另一套结果。
大数据量比较也不能全放内存里,所以做了磁盘索引存储,比较过程采用流式分页。进程退出后,已经生成的比较结果也能够恢复。
另外还处理了稳定读快照、复合主键、范围选择和乐观冲突检测。尤其是最后这个:用户预览完准备同步,目标数据库中的数据可能已经被其他人修改了,这时候不能直接把旧值覆盖过去。
这里花了不少精力。相比普通的数据复制,Data Sync 更麻烦的地方在于:用户确认要同步的内容,和最后真正写入数据库的内容,必须能够对应起来。
Data Transfer:跨数据库迁移,数据类型只是开始
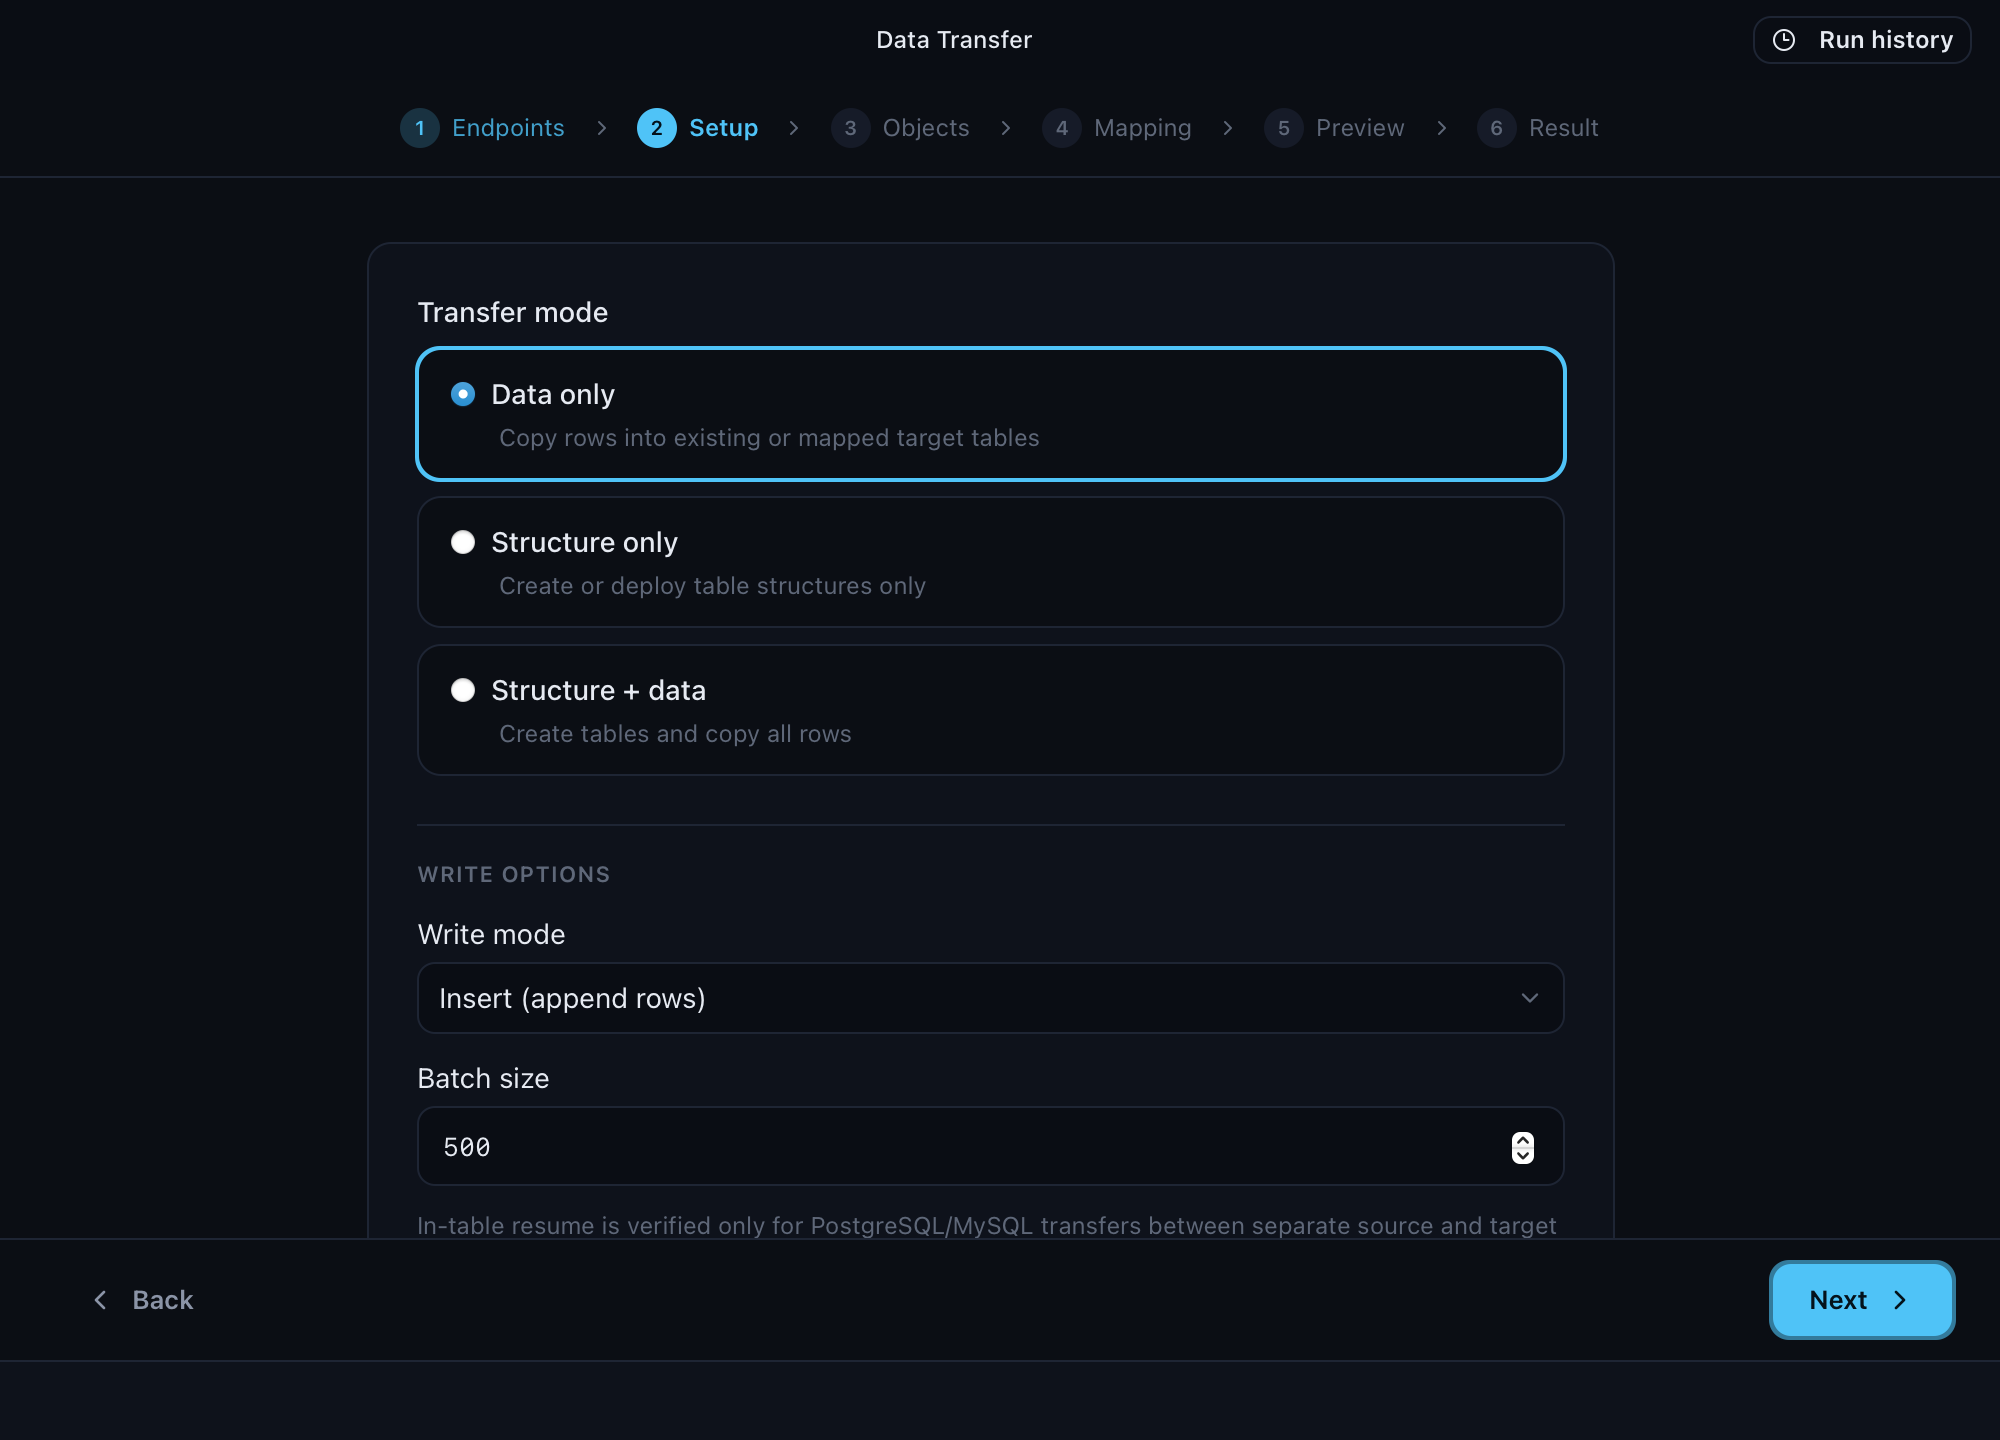
Data Transfer 和 Data Sync 不太一样。它不仅要传输数据,还要处理不同数据库之间的结构和类型差异。
拿 PostgreSQL 到 MySQL 举例,两边的数据类型不是完全对应的,自增列、序列、默认值也有不同的语义。索引、约束的定义方式不同,外键还会影响表数据的写入顺序。
有些类型甚至没法无损转换,不能随便找一个看起来相近的类型替代。
如果只是从源库读取数据,再拼成目标库的 INSERT ,碰到特殊类型、外键或者大量数据时,很容易出问题。
这部分主要做了类型和列映射,对不能确认安全转换的情况明确拒绝;写入时按照外键依赖排序,避免因为父子表顺序不对导致导入失败。
另外,为了处理大批量数据,传输过程采用分段执行和检查点机制,支持失败后的恢复和续传。这里并不是简单记录一个 offset 就可以了,还要处理检查点与实际写入之间的状态、重复写入,以及任务恢复时的边界问题。
PostgreSQL 的序列连续性、目标端主键和外键处理也花了不少功夫。
除了直接传到数据库,也支持生成 SQL 文件,包括原子写入、编码选择和 gzip 输出。
做到这里,感觉已经不只是一个数据复制功能了,更像是在数据库客户端里面实现了一个小型的数据迁移引擎。
目前的测试范围
这部分还是如实说一下。
目前这三个功能真正做过比较完整端到端验证的,主要是 PostgreSQL 和 MySQL ,覆盖了以下组合:
PostgreSQL → PostgreSQL
MySQL → MySQL
PostgreSQL → MySQL
MySQL → PostgreSQL
其他数据库驱动虽然有相应的能力接口和部分实现,但不同数据库之间的 Schema 差异、类型映射、数据写入和失败恢复,还没有完成同等程度的端到端验证。
因此,Data Sync 和 Data Transfer 对其他数据库组合会标记为实验性支持,不能认为已经达到 PostgreSQL 和 MySQL 组合的成熟度。
Schema Diff 则会根据驱动声明的迁移能力开放相应操作,不会因为数据库能够连接,就默认所有结构变更都能正确处理。
后面还需要继续补充不同数据库的真实环境测试。
关于 DataZen
除了迁移,日常数据库开发这些功能也值得试试
SQL Editor
SQL 编辑器支持基于真实数据库 Schema 的代码补全,输入表名、列名时会读取实际元数据,悬停可以查看字段类型和注释,也有函数参数提示。
多语句 SQL 支持单独执行当前语句、执行选中内容或者执行全部;另外还有参数绑定、SQL 格式化、代码片段、实时语法检查和查询结果流式加载。事务方面支持自动提交开关,以及手动 COMMIT / ROLLBACK 。对于没有 WHERE 条件的 UPDATE / DELETE ,还可以触发危险操作确认。
数据浏览和编辑
表数据采用网格方式展示,支持键盘导航、复制粘贴、单元格编辑、筛选、排序和分页。
编辑时会根据数据库字段类型使用不同的编辑控件,例如数字、日期、布尔、JSON 和枚举。修改不会直接写入数据库,而是先暂存,可以统一预览变更,再提交或回滚。
还支持多列排序、按条件组合筛选,以及通过外键直接跳转到关联表的记录。对于满足安全条件的简单 SELECT 查询,查询结果也可以直接编辑,不必专门回到原表。
数据导入导出
CSV 导入提供列映射向导,支持分批事务执行和错误报告。
导出支持 CSV 、XLSX 、Parquet 、TSV 、Markdown 、SQL UPDATE 等格式,可以选择列,查看导出进度,也可以中途取消。数据传输还支持生成 SQL 文件。
项目地址:
GitHub: https://github.com/flyxl/datazen
官网: https://flyxl.github.io/datazen/zh/
下载: https://flyxl.github.io/datazen/zh/download.html
Release: https://github.com/flyxl/datazen/releases/tag/v0.3.0
也欢迎试用 DataZen 。平时使用 Navicat 、DBeaver 、DataGrip 、TablePlus 的朋友,有什么问题或者建议都可以直接提。
 主楼
- RustyCedar1613小时前
DataZen的拓扑排序处理对象依赖关系很实用,可以考虑增加环形依赖检测功能。
- WildPanda1813小时前
用户直接操作迁移的话,会不会因为不熟悉依赖关系搞乱数据库结构?
- SwiftByte29912小时前
表之间的循环依赖关系是怎么处理的?数据同步的校验机制具体是怎么设计的?